RAG چیست؟ | آموزش Vector Database و ساخت چتبات اختصاصی با هوش مصنوعی

دیتابیس برداری (Vector Database) و RAG چیست؟ | ساخت چتبات اختصاصی
سلام به همگی! من امیر آویژه هستم و به جلسه هفتم از دوره جامع ریاضیات هوش مصنوعی خیلی خوش اومدید. تو این جلسه قراره تمام چیزای جذابی که تا الان یاد گرفتیم رو با هم ترکیب کنیم تا ببینیم تو دنیای واقعی چطوری میشه یه سیستم هوشمند و خفن ساخت.
امروز میخوایم در مورد یه مفهوم بسیار پرکاربرد به اسم RAG و وکتور دیتابیسها صحبت کنیم. پس اگه دوست دارید بدونید چطوری میشه یه هوش مصنوعی شخصیسازی شده ساخت، این مقاله رو از دست ندید.
سیستم RAG دقیقا چیست؟ (یه مثال ساده)
فرض کنید ما یه کتاب کاملاً محرمانه در مورد یک سری حیوانات ناشناخته داریم. اطلاعات این کتاب نه تو اینترنت هست و نه ChatGPT چیزی دربارهاش میدونه. وظیفه ما اینه که یه چتبات بسازیم تا هر سوالی از این کتاب داشتیم، بهمون جواب بده.
به این فرآیند میگن RAG (Retrieval-Augmented Generation). یعنی ما یه سری اطلاعات اختصاصی به هوش مصنوعی میدیم و بهش میگیم: «نیازی نیست از دانش عمومی خودت استفاده کنی؛ فقط بر اساس همین اطلاعاتی که بهت دادم جواب بده!».
مراحل ساخت سیستم RAG
وقتی میخوایم این ساختار رو توی پروژههای خودمون (مثلاً پیادهسازی بکاند با پایتون ۳.۱۲ که نسخهی کاملاً بهینه و استانداردی برای این کاره) اجرا کنیم، باید چند تا مرحله خیلی مشخص رو طی کنیم:
۱. خرد کردن متن (Chunking) و امبدینگ (Embedding)
اول از همه باید متن کتاب رو به بخشهای کوچیکتری مثل پاراگرافهای ۳۰۰ کلمهای تقسیم کنیم که بهش میگن Chunking.
بعدش این تیکهها رو با استفاده از مدلهایی مثل مدلهای Embedding شرکت OpenAI، به بُردار (Vector) تبدیل میکنیم. روشهای قدیمی مثل Word2Vec یا Bag of Words اینجا جواب نمیده، چون ما میخوایم مفهوم کل اون پاراگراف رو تو قالب یه بردار داشته باشیم.
۲. ذخیره در پایگاه داده برداری (Vector Database)
حالا این بردارهایی که ساختیم رو باید کجا نگه داریم؟ دقیقاً توی پایگاه داده برداری (مثل Chroma و…). نکته خیلی مهم اینه که کنار هر بردار، متن همون پاراگراف (Chunk) رو هم ذخیره میکنیم تا بعداً بدیمش به چتبات.
۳. پرسش کاربر و شباهتسنجی (Similarity Check)
حالا کاربر میاد یه سوال میپرسه: «این حیوان فلان چی میخوره؟». ما این سوال رو هم دوباره به یک بردار تبدیل میکنیم.
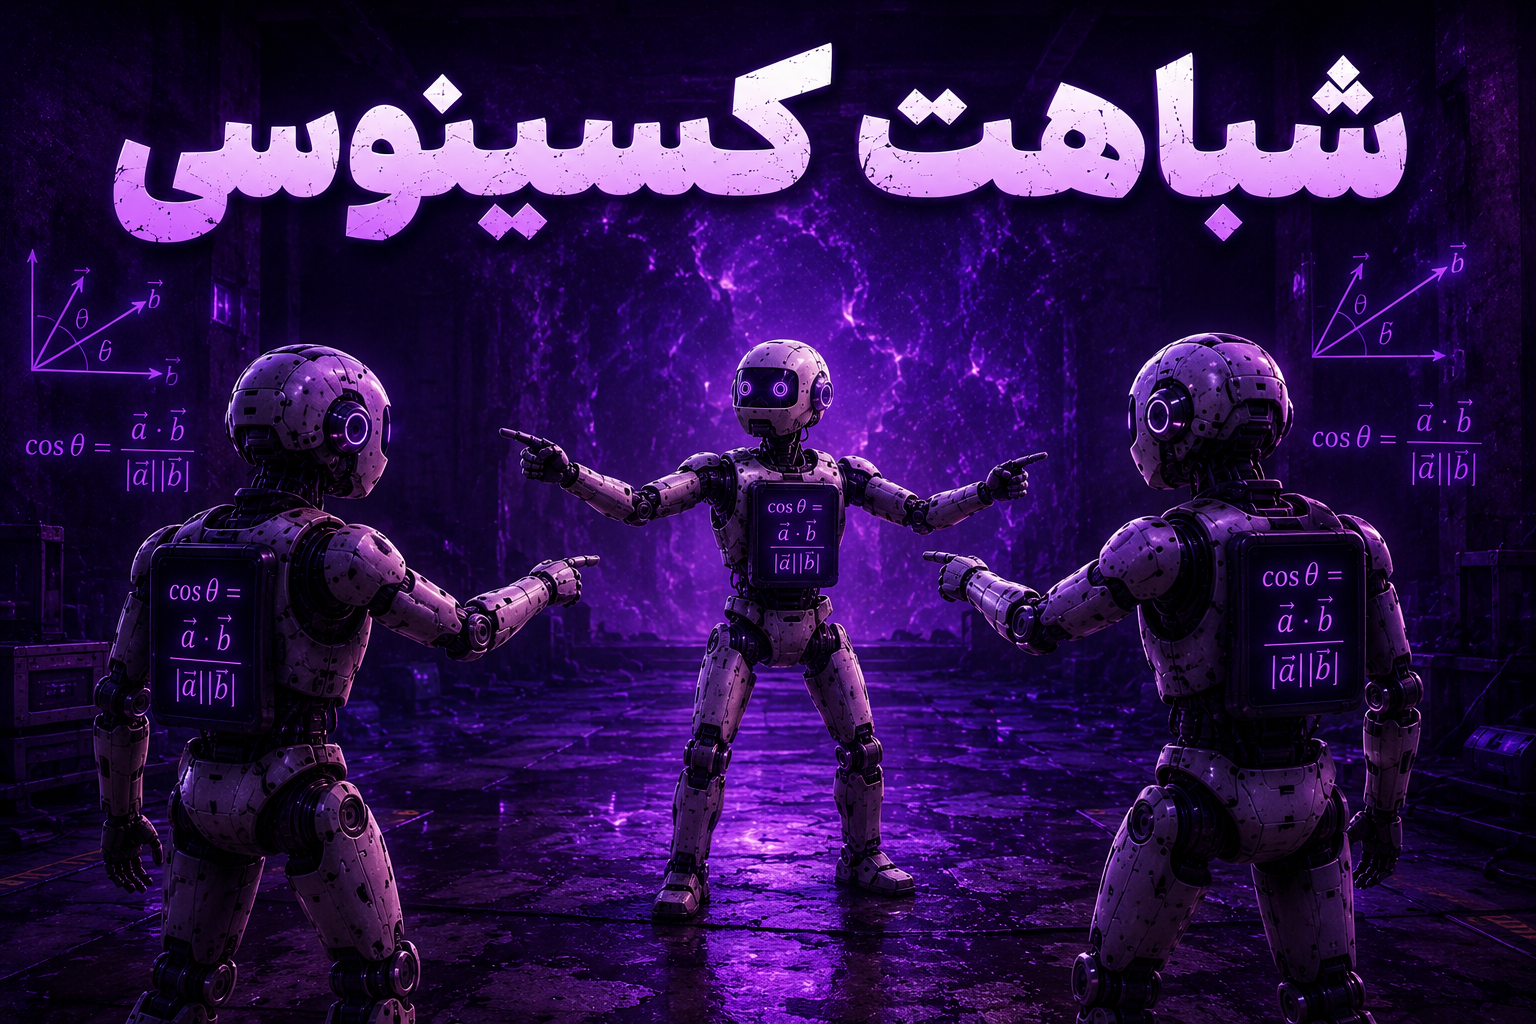
اینجاست که مفاهیم ریاضی که تو جلسه قبل خوندیم به دادمون میرسه! سیستم میره تو دیتابیس میگرده و با استفاده از شباهت کسینوسی (Cosine Similarity)، بردارِ سوال رو با تمام بردارهای ذخیره شده مقایسه میکنه. اون پاراگرافی که بالاترین شباهت (مثلاً اسکور ۰.۹۲) رو داشته باشه، به عنوان مرتبطترین متن کشیده میشه بیرون.
⚠️ مرحله نهایی: تولید جواب توسط چتبات
در نهایت، ما اون متنی که پیدا کردیم رو میدیم به مدل هوش مصنوعی (مثل ChatGPT) و بهش میگیم: «با استفاده از این متن، جواب سوال کاربر رو با جملهبندی طبیعی خودت بده». به همین سادگی و خفنی، ما یه سیستم RAG اختصاصی ساختیم!
حرف آخر…
دیدید مفاهیم پایهای که تو ۶ جلسه قبل یاد گرفتیم چطوری تو تکنولوژیهای روز دنیا مثل سیستمهای RAG استفاده میشن؟ این تازه اول راهه! با درک درست این ریاضیات، شما میتونید هر سیستم هوشمندی رو تو معماری پروژههای دیتاساینس درک کنید.