آموزش کامل شباهت کسینوسی (Cosine Similarity) در هوش مصنوعی و دیتا ساینس
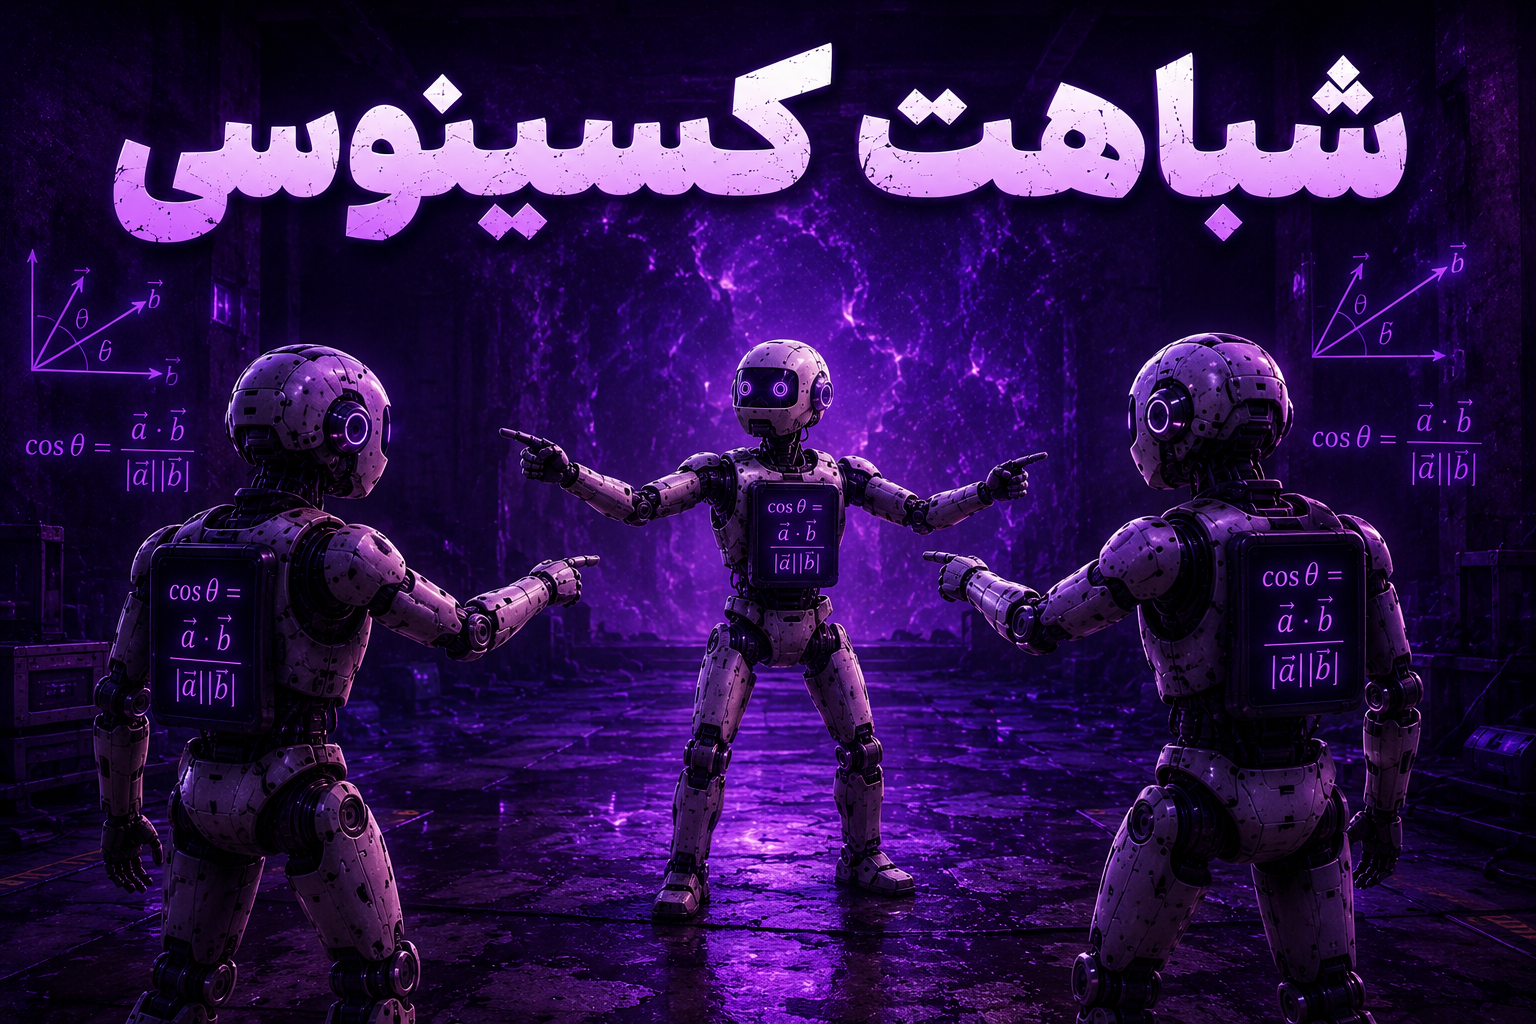
شباهت کسینوسی (Cosine Similarity) | جادوی سیستمهای پیشنهاددهنده
سلام به همگی! امیر آویژه هستم و به جلسه ششم از دوره جامع ریاضیات هوش مصنوعی خیلی خوش اومدید. امروز قراره بریم سراغ یکی از جذابترین و کاربردیترین مفاهیم جبر خطی یعنی شباهت کسینوسی (Cosine Similarity).
شاید اسمش یکم ترسناک به نظر برسه، اما بهتون قول میدم با چیزهایی که تو جلسات قبل (مثل ضرب داخلی) یاد گرفتید، درک این موضوع براتون مثل آب خوردن باشه. تو این مقاله قراره ببینیم پلتفرمهایی مثل فیلیمو یا نتفلیکس چطوری با همین فرمول ساده فیلم بعدی رو بهمون پیشنهاد میدن!
نُرم بردار (Vector Norm) چیست؟
قبل از اینکه بریم سراغ شباهت کسینوسی، باید با یه مفهوم پایه آشنا بشیم به اسم نُرم (Norm). خیلی ساده بگم: نُرم یعنی همون اندازه یا طولِ یه بردار؛ یه عدد مثبت که بهمون میگه این بردار چقدر بلنده.
ما دو مدل نُرم خیلی معروف داریم: نرم اقلیدسی (L2) و نرم منهتن (L1). فعلاً تمرکز ما روی نُرم اقلیدسی هست.
چطوری نرم اقلیدسی رو حساب کنیم؟
فرض کنید یه بردار داریم با یه سری اعداد (مثلاً [2, 2, 3, 4, …]). برای محاسبه طول این بردار با نرم اقلیدسی، فقط کافیه این مراحل رو بریم:
- تمام اعداد داخل بردار رو به توان ۲ میرسونیم.
- همه اون اعداد تواندار رو با هم جمع میکنیم.
- در نهایت از حاصلجمعشون یه جذر (رادیکال) میگیریم.
مثلاً برای بردار [2, 2, 3, 4, 2] اول به توان دو میرسونیم که میشه (4, 4, 9, 16, 4). بعد با هم جمعشون میکنیم که میشه 37. پس طول این بردار میشه رادیکال 37! به همین راحتی.
شباهت کسینوسی چیه و چطوری کار میکنه؟
حالا میرسیم به اصل ماجرا! شباهت کسینوسی یه معیار فوقالعاده است که نشون میده دو تا بردار چقدر به هم شباهت دارن. این معیار یه امتیازی بین ۱ تا ۱- به ما میده:
| امتیاز خروجی | معنی و مفهوم |
|---|---|
| نزدیک به 1+ | یعنی دو تا بردار به شدت شبیه به همن و همجهت هستن. |
| نزدیک به 0 | یعنی هیچ ربطی به هم ندارن (عمود بر همن). |
| نزدیک به 1- | یعنی کاملاً با هم متضاد و خلاف جهت هستن. |
فرمول شباهت کسینوسی
فرمولش واقعاً ساده است. یه کسر (تقسیم) در نظر بگیرید:
تو صورت کسر: ضرب داخلی دو تا بردار رو مینویسیم (تو جلسه ۵ یاد گرفتیم).
تو مخرج کسر: طول بردار اول (نُرم) رو ضربدر طول بردار دوم میکنیم.
حاصل این تقسیم میشه همون شباهت کسینوسی ما!
مثال واقعی: سیستم پیشنهاد فیلم (Recommendation System)
بیاین همه این فرمولها رو تو یه مثال واقعی و جذاب تو دنیای دیتا ساینس پیاده کنیم. فرض کنید شما تو یه اپلیکیشن، فیلم «میانستارهای (Interstellar)» رو تماشا کردید. سیستم، ویژگیهای این فیلم رو (درام، عاشقانه، ترسناک، آخرالزمانی و…) به شکل یک بردار ذخیره کرده: [1, 2, 0, 3, 1].
حالا سیستم یه فیلم دیگه تو دیتابیس داره که بردارش اینه: [2, 0, 1, 1, 1]. سوال اینه: آیا سیستم باید این فیلم جدید رو به شما پیشنهاد بده یا نه؟
🛠️ بریم برای محاسبه:
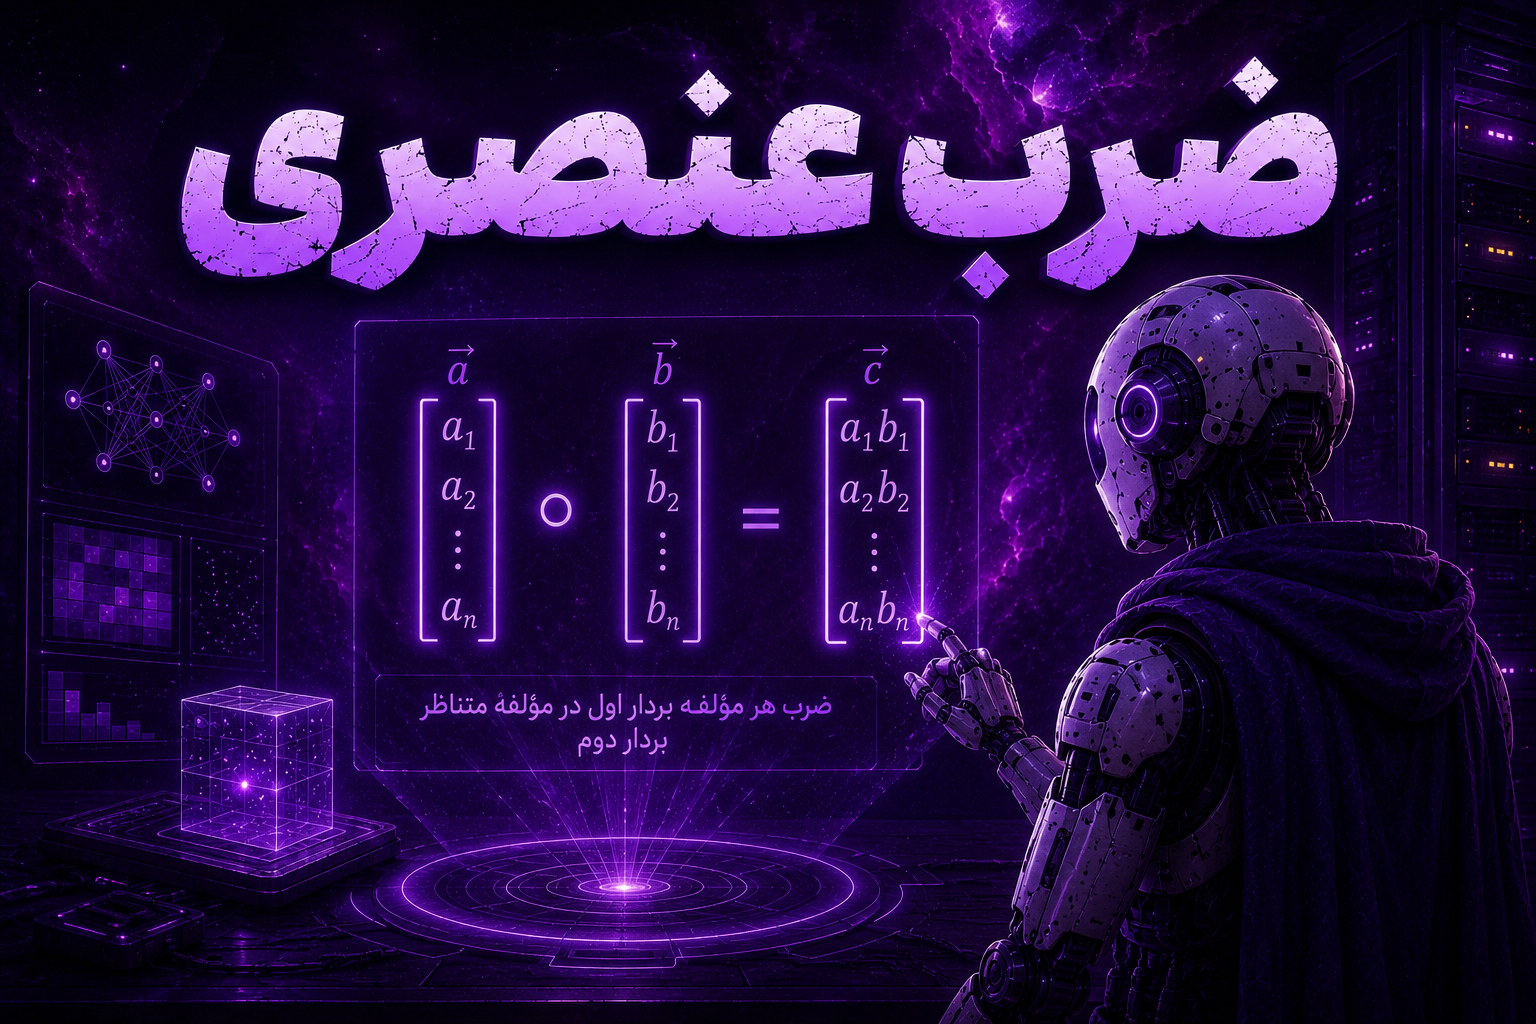
مرحله اول (ضرب داخلی): دو تا بردار رو نظیر به نظیر ضرب و جمع میکنیم.
(1×2) + (2×0) + (0×1) + (3×1) + (1×1) = 6 (این میشه صورت کسر).
مرحله دوم (محاسبه نُرمها):
نُرم فیلم اول: رادیکال 15 (حدوداً 3.87)
نُرم فیلم دوم: رادیکال 7 (حدوداً 2.64)
حالا این دو تا رو تو هم ضرب میکنیم که میشه حدوداً 10.24 (این میشه مخرج کسر).
تو مرحله آخر، 6 رو تقسیم بر 10.24 میکنیم. جواب میشه 0.586!
این یعنی چی؟ یعنی سیستم پیشبینی میکنه که حدود ۵۸ درصد شباهت بین این فیلم و سلیقه شما وجود داره. اگر این عدد مثلاً بشه ۰.۹ (۹۰ درصد)، فیلم قطعاً به عنوان پیشنهاد اول (Recommendation) تو صفحه اصلی شما ظاهر میشه!
حرف آخر…
به همین راحتی و فقط با چند تا عمل جمع و ضربِ ساده، شما الان منطق پشت یکی از پیچیدهترین و پولسازترین سیستمهای هوش مصنوعی تو دنیا (سیستمهای توصیهگر) رو درک کردید. دیدید ریاضیات چقدر میتونه شیرین و کاربردی باشه؟
اگه هرجای این محاسبات براتون گنگ بود، حتماً ویدیو رو چند بار با دقت ببینید.

سلام، عجیب ترین و ساده ترین روشی بود که میتونستم یک چیز پیچیده رو یاد بگیرم، خیلی ممنونم ❤